Selbsttest
Frage 1 / 3
Beim Prüfen werden deine Antwort und der Beitrag über OpenRouter an ein KI-Modell gesendet. Das Feedback kann falsch sein. Bitte keine vertraulichen Angaben eingeben.
Was sind eigentlich KI-Rechenzentren?
Eine Frage nach einer Kaffeemaschine verlässt dein Handy. Wir verfolgen den Weg durch Glasfaser, Server-Racks, GPUs und Kühlkreisläufe und trennen veröffentlichte Messwerte von offenen Fragen.
Kaufen oder mieten? Probier’s aus.
Beispiel: tagsüber viele KI-Anfragen, nachts wenig. Beide Optionen liefern dieselbe angenommene Rechenleistung. Verschieb die Regler und beobachte, wie Bedarfsspitzen und Leerlauf die Kosten verändern.
Cloud
438 €/ Monat
15.779 € über 36 Monate
Eigene Hardware
522 €/ Monat
18.789 € über 36 Monate
Benötigte eigene Systeme: 1 · Einmaliger Kauf: 12.000 € · Strom pro Monat: 39 €.
Der Kauf würde sich gegenüber Miete nach ungefähr 48 Monaten ausgleichen.
Weitere Annahmen und Rechenweg
Monat = 730,5 Stunden. Kauf: Hardware für die Bedarfsspitze, über den Zeitraum verteilt, plus Strom und Wartung. Miete: aktive oder reservierte GPU-Stunden × Stundenpreis. Strom: aktive Stunden × Arbeitsleistung plus übrige Stunden × Leerlaufleistung. Preise sind veränderbare Beispielannahmen; Steuern, Finanzierung, Personal über den Wartungsbetrag hinaus, Netzkosten und Hardware-Wiederverkauf sind nicht berücksichtigt.
Eine Frage verlässt das Handy
Du tippst am Küchentisch eine einfache Frage in dein Handy: „Ich suche eine Kaffeemaschine bis 200 Euro, leicht zu reinigen.“ Nach wenigen Augenblicken erscheinen die ersten Wörter auf dem Bildschirm. Doch das Handy hat diese Antwort nicht selbst berechnet.
Hinter dem Begriff „Cloud“ steckt keine körperlose Wolke, sondern eine physische Kette aus Leitungen, Verteilern, Spezialrechnern, Stromnetzen und Kühlanlagen. Unser Kaffeemaschinen-Satz ist ein erfundenes Lehrbeispiel: Wir verfolgen den Weg dieser Nachricht vom Bildschirm bis in die Rechnerhalle und zurück.
Vom Bildschirm bis in die Rechnerhalle
Sobald du auf Senden tippst, verpackt die App deinen Text zusammen mit dem bisherigen Gesprächsverlauf in eine verschlüsselte Anfrage. Über Mobilfunk oder WLAN und weiter durch Glasfaserkabel erreicht das Datenpaket ein Rechenzentrum.
Dort übernimmt zuerst ein Eingangs-Dienst die Koordination: Er prüft die Zugangsberechtigung, reiht die Anfrage in eine Warteschlange ein und leitet den Auftrag an einen freien Rechenknoten weiter, auf dem das gewünschte Sprachmodell bereits geladen ist.
Was in den Server-Schränken steckt
In der Halle stehen lange Reihenmannshoher Metallschränke, sogenannte Racks. Darin sitzen flache Einschub-Computer (Server) mit eng gekoppelten GPUs oder KI-Beschleunigern, die viele Zahlenoperationen gleichzeitig berechnen, sowie schnellem HBM-Speicher direkt neben dem Rechenchip, in dem die Milliarden Modellgewichte bereitliegen. Schnelle Netzwerkverbindungen koppeln mehrere Chips und Racks zusammen, wenn ein großes Modell nicht auf eine einzelne Karte passt.
Zwei verschiedene Aufgaben: Training und Antwort
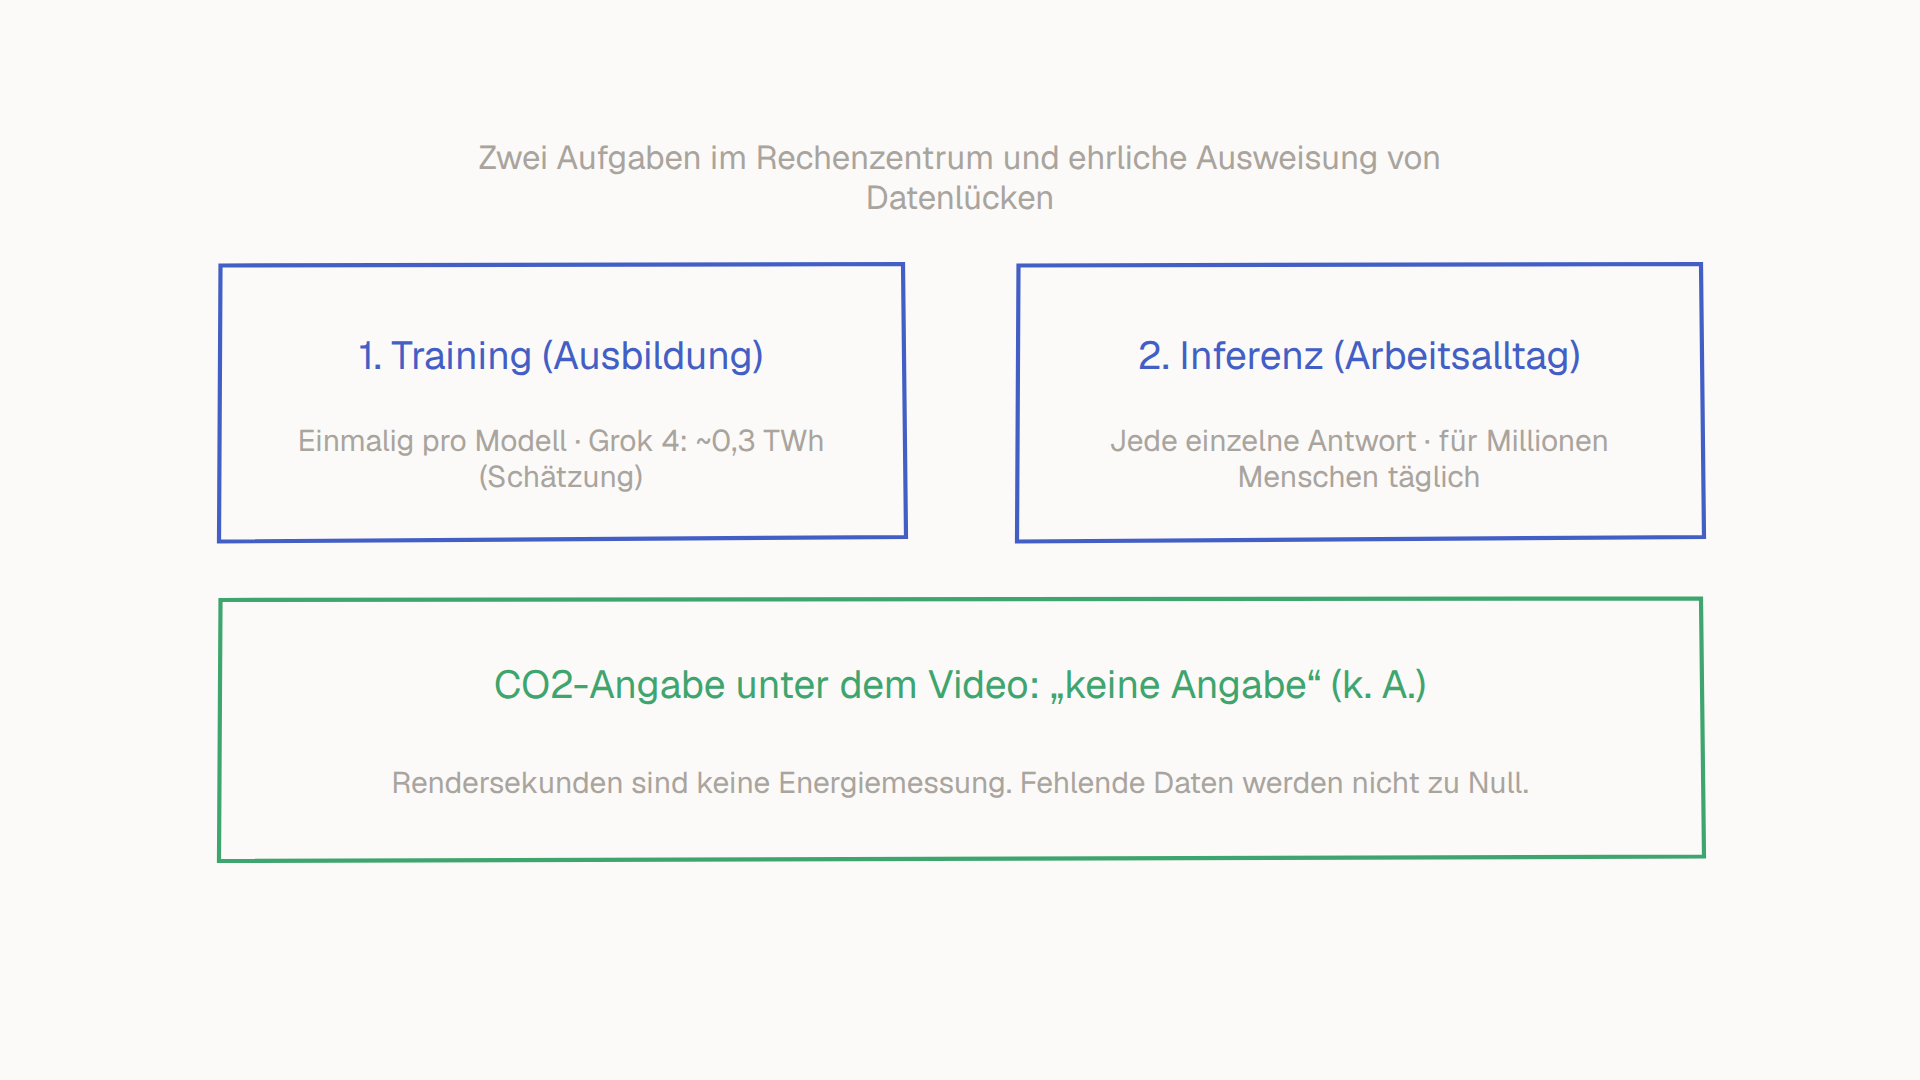
Im Rechenzentrum laufen zwei sehr unterschiedliche Aufgaben:
- Training: Tausende Beschleuniger arbeiten über Wochen oder Monate gemeinsam an riesigen Text- und Datensammlungen und passen die Gewichte eines neuen Modells schrittweise an.
- Inferenz (Anwendung): Die gelernten Gewichte liegen fertig im Speicher. Kommt deine Kaffeemaschinen-Frage herein, berechnet das System Wortteil für Wortteil (Token für Token) die wahrscheinlichste Fortsetzung und schickt die Antwortteile laufend an dein Handy zurück.
Strom, Abwärme und Kühlung
Fast jede Kilowattstunde Strom, die ein Rechenchip aufnimmt, wird am Ende zu Wärme. Um die dicht gepackten Racks im Betrieb zu halten, führen Gebläse oder direkte Flüssigkeitskühlungen an den Chips die Wärme ab.
Die Kennzahl PUE (Power Usage Effectiveness) setzt den gesamten Strombedarf des Gebäudes ins Verhältnis zum Strom der IT-Geräte: Ein PUE von 1,10 bedeutet, dass auf 1,00 kWh Rechnerstrom noch 0,10 kWh für Kühlung und Stromverteilung entfallen. Ob zur Rückkühlung auch Wasser verdunstet wird, hängt stark vom Kühlsystem, dem Standort und dem Wetter ab.
Was Studien und Anbieter messen und was offen bleibt
Die Internationale Energieagentur (IEA) und das Lawrence Berkeley National Laboratory (LBNL) zeigen einen deutlich wachsenden Strombedarf von Rechenzentren; KI ist dabei ein wichtiger Wachstumstreiber, steht aber neben klassischem Cloud-Betrieb, Video-Streaming und Unternehmenssoftware.
Für einzelne Textanfragen hat Google im Mai 2025 eine eigene Messung für einen medianen Gemini-Textprompt veröffentlicht: rund 0,24 Wattstunden Strom, etwa 0,03 Gramm CO₂e und 0,26 Milliliter Wasser (ungefähr fünf Tropfen). Diese Zahl gilt ausdrücklich für Googles untersuchte Flotte, eigene Kühlung und das gewählte Berechnungsverfahren. Für andere Anbieter, längere Gespräche, Bild- oder Videogenerierung oder Reasoning-Aufträge mit vielen Zwischenschritten bleibt der genaue Verbrauch einer einzelnen Anfrage ohne vergleichbare Messung unbekannt.
Drei Prüffragen für jede Infrastruktur-Zahl
Wenn du künftig eine große Zahl über den Strom- oder Wasserverbrauch von KI liest, helfen drei Fragen:
- Welche Aufgabe wurde gezählt? Geht es um das monatelange Training, eine kurze Textantwort oder einen langen Agentenlauf?
- Welche Systemgrenze gilt? Wurde nur der Chip gemessen, das ganze Gebäude inklusive Kühlung oder auch der lokale Strommix?
- Ist es Messung oder Hochrechnung? Stammt der Wert aus echten Betriebsdaten oder aus einer vereinfachten Schätzung?
Meine Notizen
Notizen und Markierungen zu diesem Beitrag
Nur in diesem Browser gespeichert. Es wird nichts gesendet.
Hier landen deine Notizen und Markierungen.
Markiere im Text eine Stelle und wähl „Markieren“ oder „Notiz“. Oder schreib gleich eine Notiz zum ganzen Beitrag.
Selbsttest
Erkläre die Ideen in eigenen Worten, direkt im Videoplayer.