Selbsttest
Frage 1 / 3
Beim Prüfen werden deine Antwort und der Beitrag über OpenRouter an ein KI-Modell gesendet. Das Feedback kann falsch sein. Bitte keine vertraulichen Angaben eingeben.
Wie schnell wird KI wirklich besser?
Bei Humanity’s Last Exam springt die Trefferquote in 15 Monaten von 2,7 % auf 64,7 %. Bei METR wächst der gemessene Aufgabenhorizont. Doch was trennt einen gelösten Test von einer Entscheidung in der echten Welt?
Ein steiler Sprung bei einer schweren Prüfung
Im Januar 2025 stellten Forscherinnen und Forscher Humanity’s Last Exam (HLE) vor: 2.500 schwere Fachfragen aus Mathematik, Natur- und Geisteswissenschaften mit eindeutig prüfbaren Antworten. In der offiziellen Basistabelle lag GPT-4o bei 2,7 %.
Rund 15 Monate später, am 7. April 2026, meldete Anthropic für Claude Mythos Preview 56,8 % ohne Werkzeuge und 64,7 % mit Werkzeugen. Wie passt dieser steile Sprung zu dem Eindruck im Alltag, dass KI bei manchen Aufgaben enorm hilft und bei anderen überraschend scheitert?
Was ein Fragen-Benchmark misst und was zur Zahl gehört
Ein Benchmark ist eine standardisierte Vergleichsprüfung: Er bekommt eine feste Aufgabensammlung, legt sie einem Modell unter definierten Regeln vor und vergleicht die Ausgaben mit den bekannten Musterlösungen.
Beim Vergleich zwischen den frühen 2,7 % und den späteren 64,7 % gehören vier Bedingungen zwingend zur Zahl:
- Versuchsaufbau: Es handelt sich um einen historischen Vergleich verschiedener Modellgenerationen, nicht um ein identisches Laborexperiment.
- Werkzeuge: Ohne Werkzeuge lag Mythos Preview bei 56,8 %, mit Werkzeugen wie Code-Ausführung und Suche bei 64,7 %.
- Mögliche Memorierung: Anthropic weist selbst darauf hin, dass Überschneidungen mit Trainingsdaten oder Lösungswegen im Netz nicht vollständig ausgeschlossen werden können.
- Abgeschlossene Fragen: HLE prüft einzelne Fragen mit feststehender Lösung, keine mehrtägigen Projekte mit offenen Anforderungen.
METR: Von einzelnen Antworten zu mehrstündigen Aufträgen
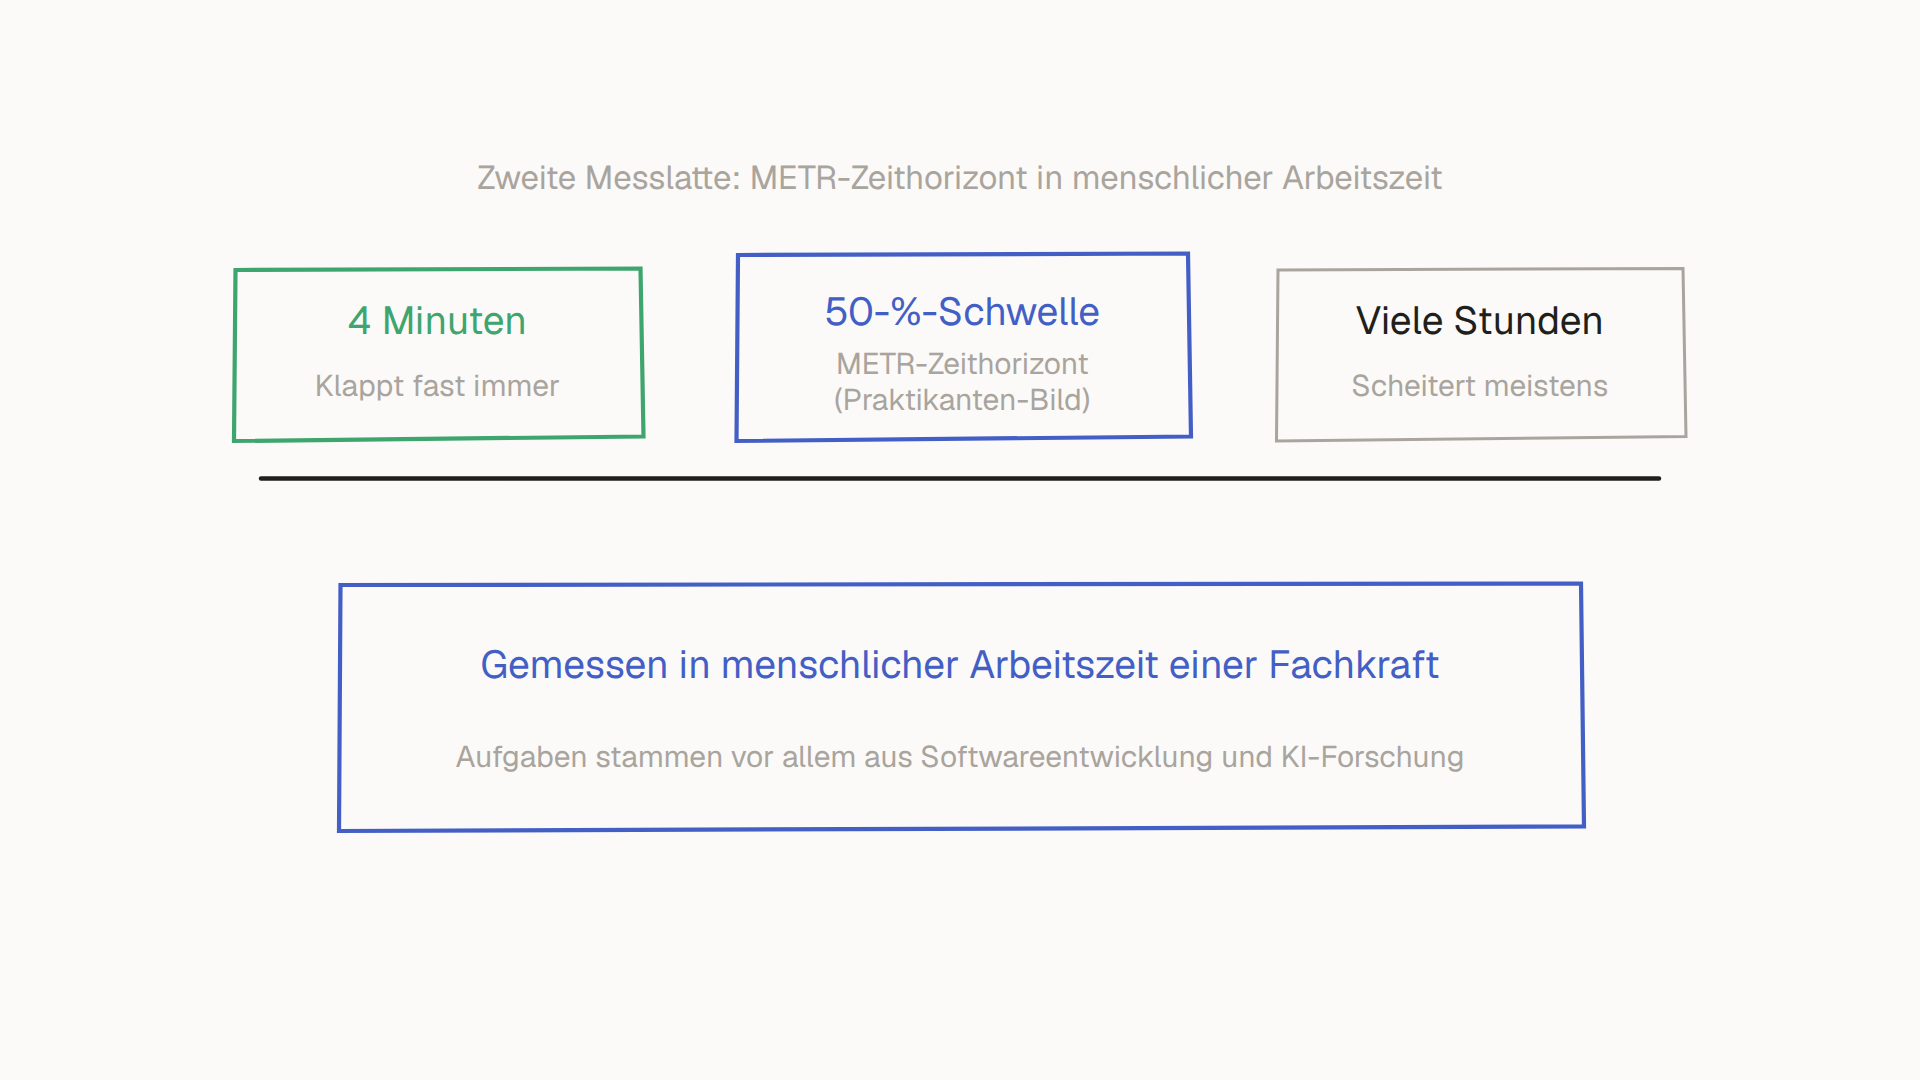
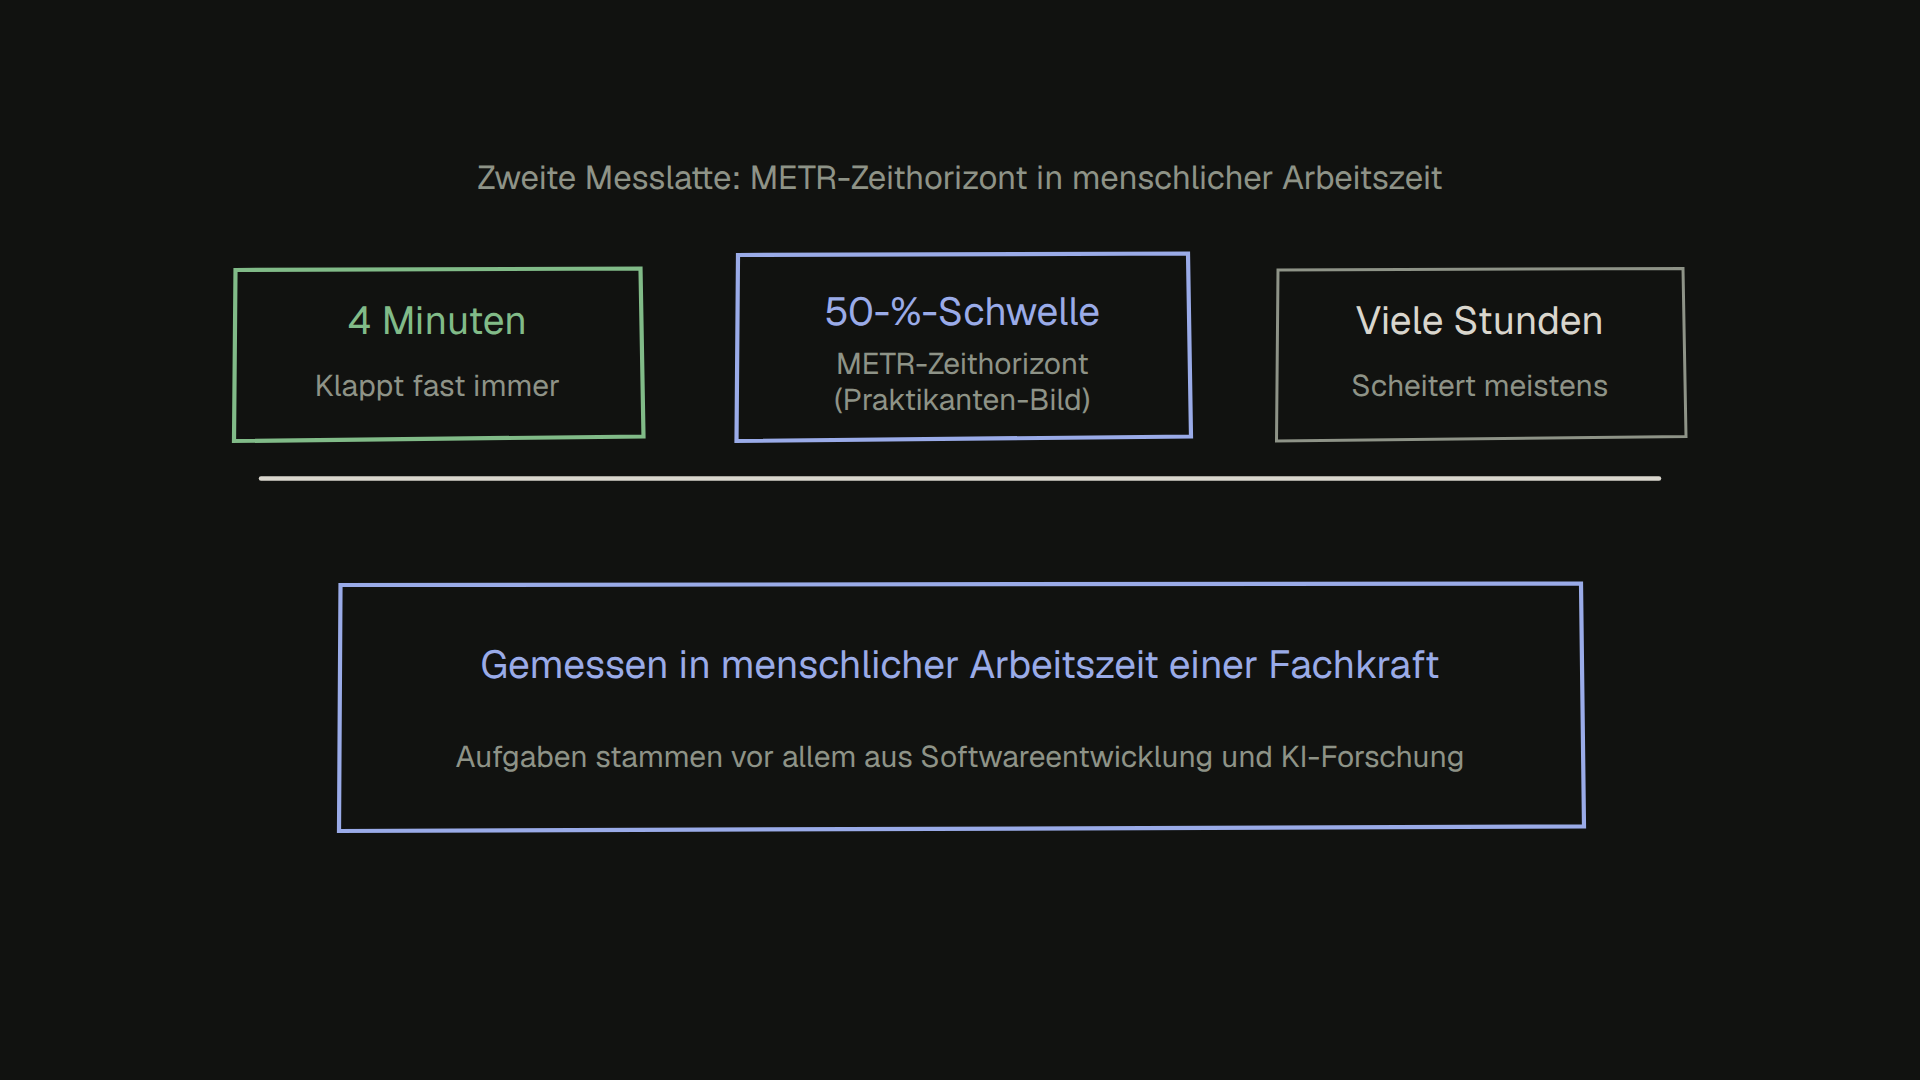
Die Forschungsorganisation METR untersucht deshalb vollständige Aufgaben aus Softwareentwicklung, Recherche und Sicherheit. Gemessen wird der 50-%-Zeithorizont: Wie lange braucht ein qualifizierter Mensch typischerweise für eine Aufgabe, bei der das KI-System in der Hälfte der Fälle erfolgreich ins Ziel kommt?
Wichtig für die Einordnung sind drei verschiedene Uhren:
- Menschliche Aufgabenzeit: der Maßstab auf der METR-Achse (z. B. eine Aufgabe, für die ein Mensch zwei Stunden braucht).
- KI-Laufzeit: wie viele Minuten oder Stunden das System tatsächlich rechnet.
- Wartezeit auf Rückmeldung: wie lange es in der echten Welt dauert, bis überhaupt feststeht, ob das Ergebnis gut war.
In der TH1.1-Auswertung vom 29. Januar 2026 lag die geschätzte Verdopplungszeit für den Trend seit 2024 bei 88,6 Tagen (knapp drei Monaten); in der längeren historischen Reihe ab 2019 bei 196,5 Tagen. Eine bedingte Beispielrechnung zeigt die Dynamik: Falls sich ein 2-Stunden-Horizont viermal verdoppelt (2 → 4 → 8 → 16 → 32), landet der Rechenwert bei 32 menschlichen Aufgabenstunden. Das ist eine Wenn-dann-Rechnung, keine garantierte Zukunftsprognose.
Die zweite Uhr: Wann gibt die Realität Rückmeldung?
Warum bedeutet selbst ein langer Aufgabenhorizont im Softwaretest nicht automatisch, dass KI jede komplexe Entscheidung übernehmen kann? Weil Aufgaben sehr unterschiedliche Rückmeldeschleifen haben:
- Sekunden bis Minuten: Du reparierst eine kleine Tabelle für die Wochenplanung der Bäckerei und prüfst sofort, ob alle Schichten besetzt sind und die Summen stimmen.
- Wochen: Du gestaltest das Bestellformular eines Online-Shops um. Ob Kundinnen und Kunden wirklich besser zurechtkommen, zeigt sich erst nach Wochen echter Nutzung.
- Jahre: Du entscheidest über den Standort einer neuen Filiale oder ein langfristiges Investment. Eine KI kann dafür Berichte zusammenfassen und Szenarien durchrechnen, aber ob sich die Entscheidung bewährt, zeigt die Realität erst nach Jahren.
Meine Notizen
Notizen und Markierungen zu diesem Beitrag
Nur in diesem Browser gespeichert. Es wird nichts gesendet.
Hier landen deine Notizen und Markierungen.
Markiere im Text eine Stelle und wähl „Markieren“ oder „Notiz“. Oder schreib gleich eine Notiz zum ganzen Beitrag.
Selbsttest
Erkläre die Ideen in eigenen Worten, direkt im Videoplayer.